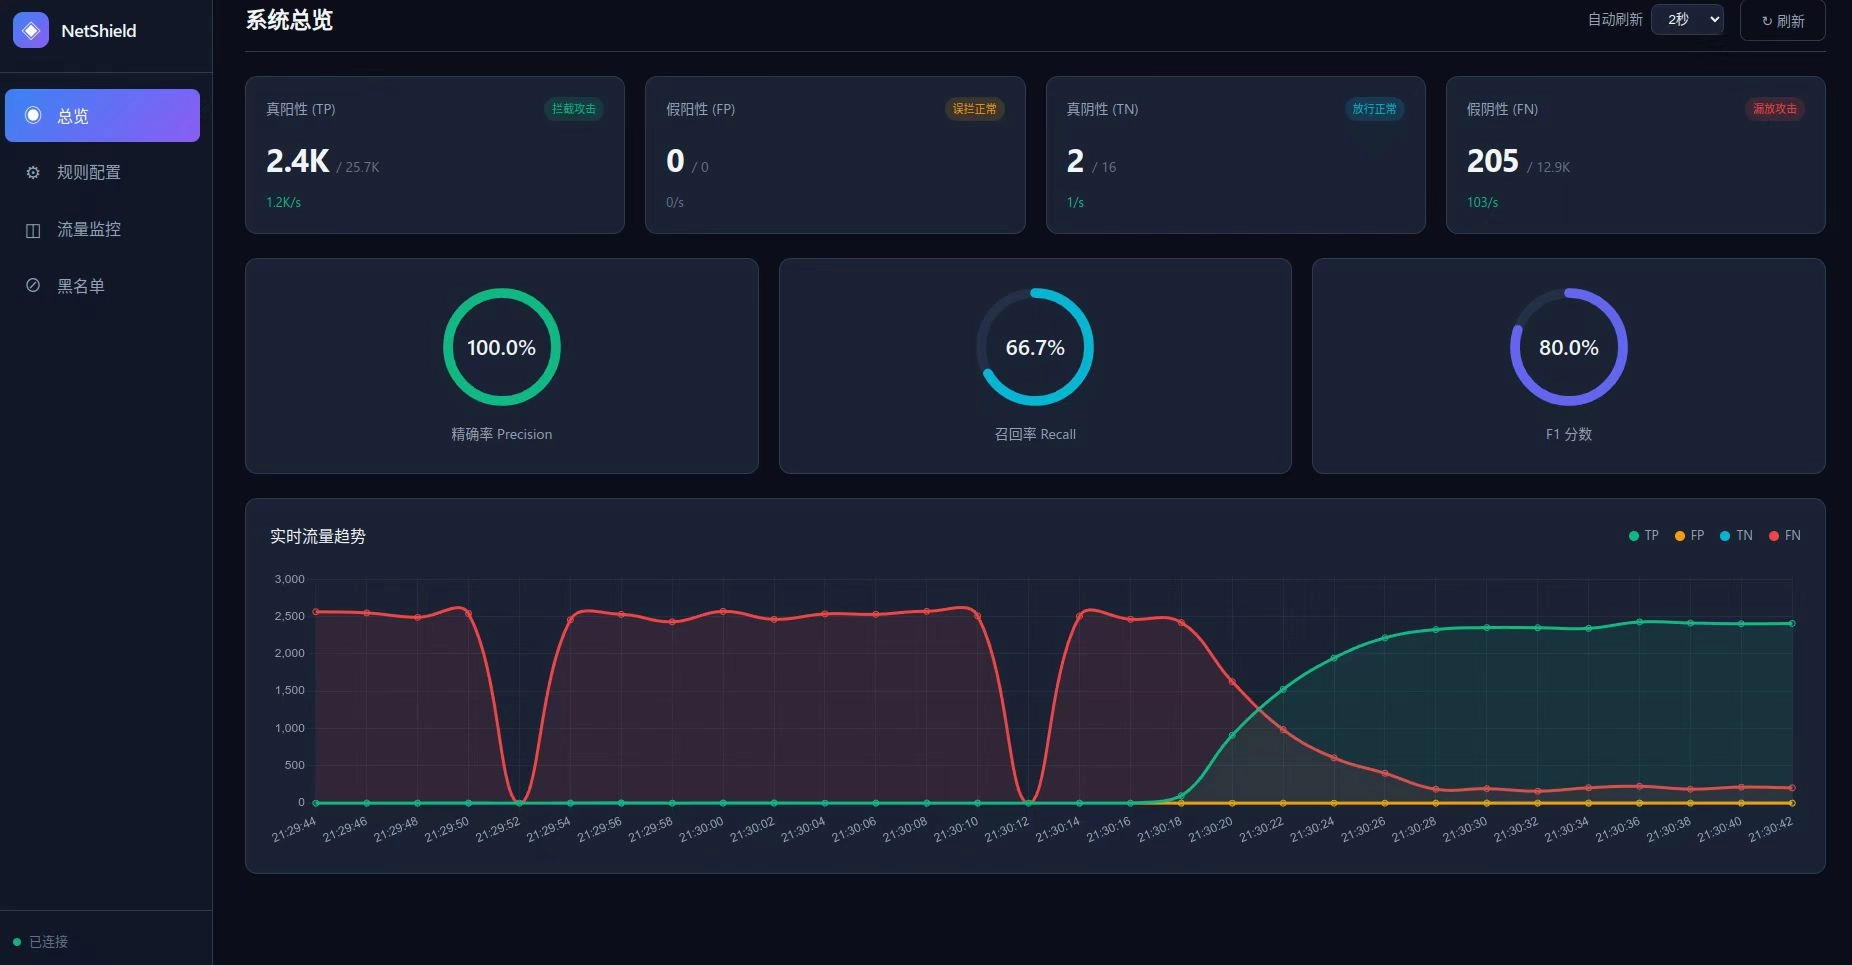
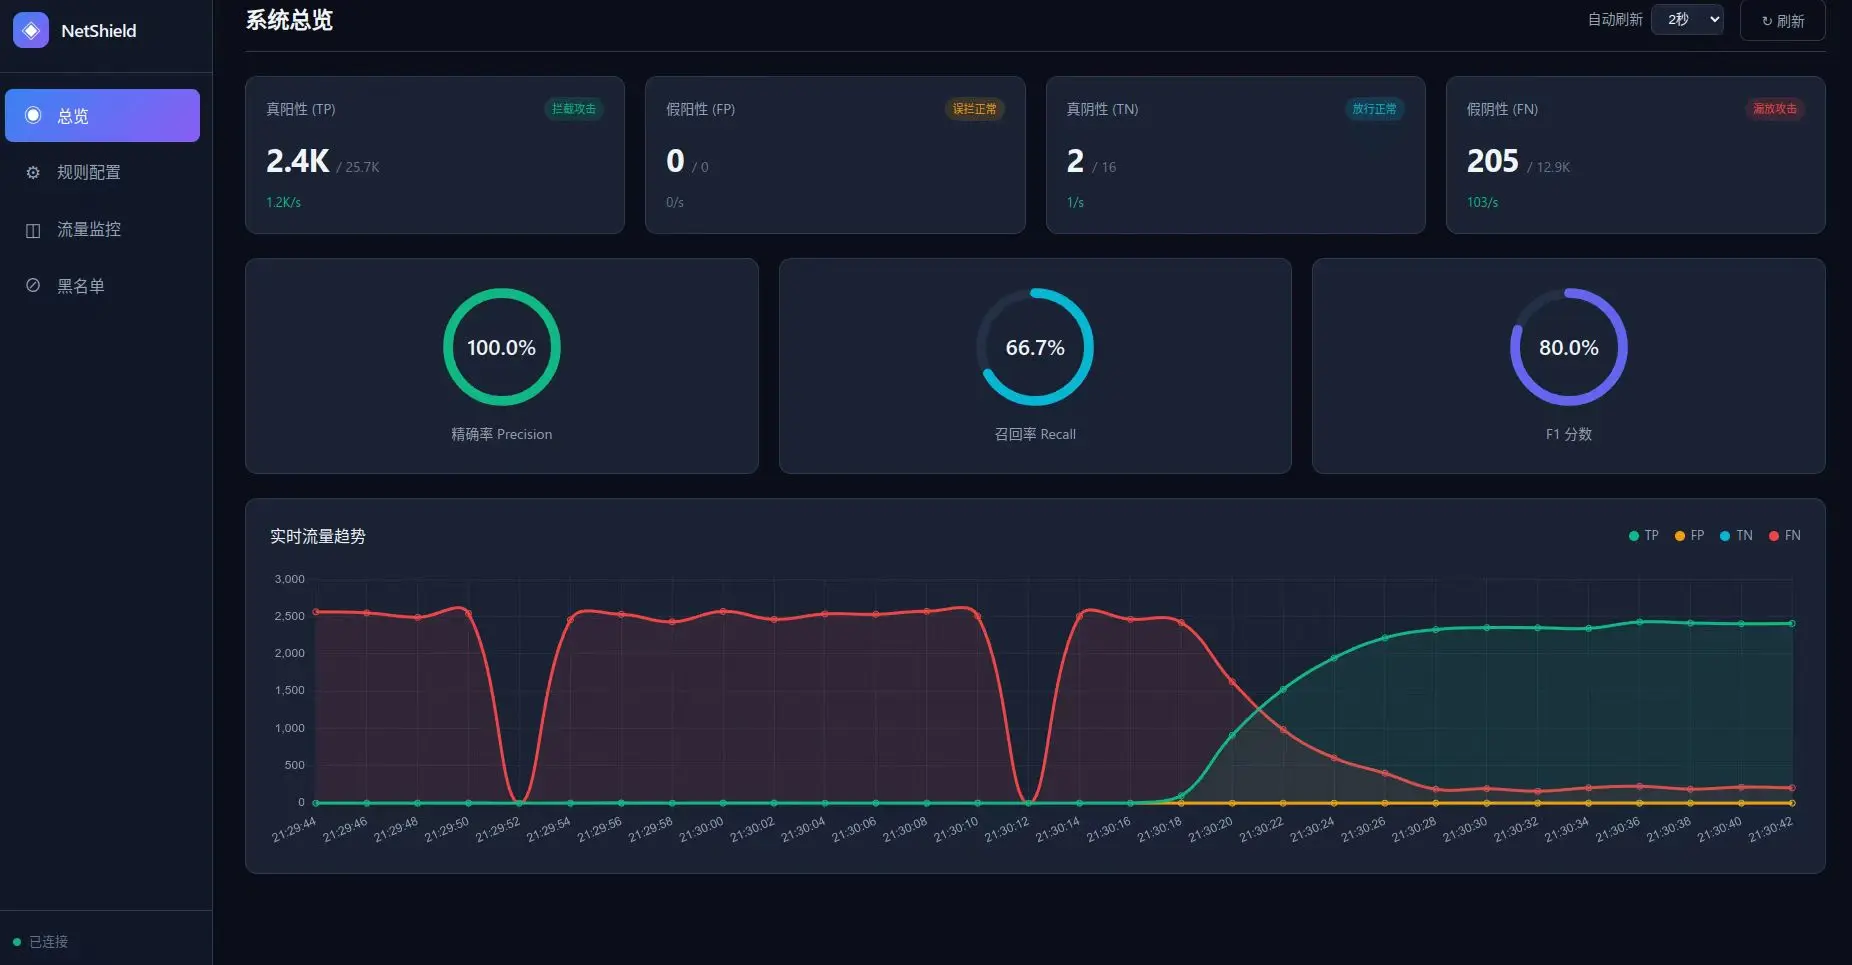
DDoS 攻击与防护模拟平台
DDoS-Sim 是一个集攻击模拟、流量监控与智能防御于一体的实验平台。
区别于传统的静态防火墙,本项目核心亮点在于引入强化学习(Reinforcement Learning),训练 Agent 动态调整防御策略,在”拦截恶意流量”与”保障正常访问”之间寻找最优平衡。
项目背景
DDoS(分布式拒绝服务)攻击原理简单,利用海量流量淹没目标,但防御却极其困难。传统的防御手段通常依赖静态阈值(如:每秒限制 100 个包),这种”一刀切”的策略在面对波动流量时往往捉襟见肘——要么防不住,要么误伤友军。
为了解决这个问题,我和同学开发了这个闭环攻防演练平台,旨在探索 AI (PPO算法) 在网络安全防御中的工程落地。
系统架构:容器化与微服务
为了解决环境依赖冲突并确保系统的高可用性,我们采用了 Docker 容器化微服务架构:
- 攻击侧:Attacker (脚本注入) + Bot (僵尸节点) + C2 Server (指令控制)
- 受害侧:Victim (Nginx/Flask 服务,模拟真实脆弱业务)
- 防御侧(核心):
- Defender (执行层):基于 Python 和 Linux nftables 的轻量级网关,负责执行规则、采集流量特征
- RL Agent (决策层):独立容器,运行深度强化学习模型,通过 RESTful API 与 Defender 交互; 这样即使模型训练占满 CPU,也不会拖垮防火墙的数据转发能力,保证了防御系统的稳定性。
核心创新
我们将 DDoS 防御建模为一个动态调参问题,利用 AI 实现自适应防护。
1. 状态感知 (Observation Space)
摒弃死记硬背,学习攻击模式。
初期的尝试中,我们直接输入原始 IP 或包数量,导致模型难以收敛。最终,我们设计了一套全归一化的特征向量:
- 流量成分:SYN 包占比、UDP 包占比
- 异常特征:异常 TTL 流量占比(作为 Ground Truth)
- 攻击分布:最大单 IP 流量集中度(以此区分 DoS 与 DDoS)
- 系统状态:CPU 负载与当前的拦截率
2. 决策输出 (Action Space)
从离散调整到连续控制。
为了应对突发流量,我们将动作空间设计为 [-1, 1] 的连续空间 (Continuous Space)。Agent 的输出经过线性映射,直接控制底层 nftables 的物理参数:
- 全局限速阈值 (
global_limit) - 单 IP 速率限制 (
per_ip_limit) - 自动封禁灵敏度 (
ban_threshold)
相比离散动作(如”阈值+10%”),连续控制能一步到位地调整防御强度,将响应速度提升至毫秒级。
3. 奖励机制 (Reward Function)
解决”数值主导”问题。
在 DDoS 场景中,攻击流量往往远超正常流量(10w vs 10)。直接使用流量数值计算奖励,会导致模型为了追求高拦截数而”一刀切”封死所有连接。
我们提出了基于比率 (Rate-based) 的奖励公式:
R = R_recall - (λ × R_fpr)- 正向奖励:攻击拦截率 (R_recall)
- 负向惩罚:正常流量误杀率 (R_fpr),并赋予高权重 (λ=5)
这一设计迫使 Agent 必须在”防住攻击”的同时小心翼翼地保护正常流量,实现了真正的智能平衡。
最终落地效果
最终,我们构建了一个闭环的智能防御系统:
- 感知层 (Eyes):
packet_monitor服务在后台运行,利用 Scapy 的 BPF 过滤器高效抽样流量,计算流量成分的比率特征 - 执行层 (Hands):
defense_api充当数据融合中心,将底层特征打包提供给 RL,并将 RL 指令转化为 nftables 规则 - 决策层 (Brain):独立的
rl_agent容器运行 PPO 算法,通过与环境的持续交互(试错),学习最优参数 - 环境层 (World):攻击侧实现了混合攻击接口,用户侧引入了流量大小和发送间隔的随机化 (Jitter),防止模型过拟合
总结
DDoS-Sim 不仅是一个演示平台,更是一次对 AI + Security 的工程实践。通过将底层的流量清洗能力与上层的强化学习决策能力相结合,我们证明了数据驱动的动态防御在应对复杂网络攻击时的巨大潜力。
技术栈
- Python:主要开发语言,用于攻击脚本、防御系统和监控工具
- Docker:容器化部署,便于环境隔离和扩展
- NFTables:Linux 防火墙,实现流量过滤和限流
- 强化学习:在复杂环境中自动优化防御策略
- Web 技术:HTML/CSS/JavaScript,用于控制面板和监控界面
← Back to projects